
关键词采集 · 多引擎切换 · 模板保存 · 代理线程 · 验证处理
📌 工具定位:水淼关键词网址采集器3.5是一款批量采集搜索引擎结果的工具,支持百度、搜狗、360、必应、谷歌等13个引擎切换、模板保存、代理线程配置、验证处理,适用于关键词网址采集场景。文章源自指令流-https://zhilingliu.cloud/475.html
文章源自指令流-https://zhilingliu.cloud/475.html
做SEO或内容运营,最耗时间的不是写文章,而是批量采集关键词对应的网址和标题。文章源自指令流-https://zhilingliu.cloud/475.html
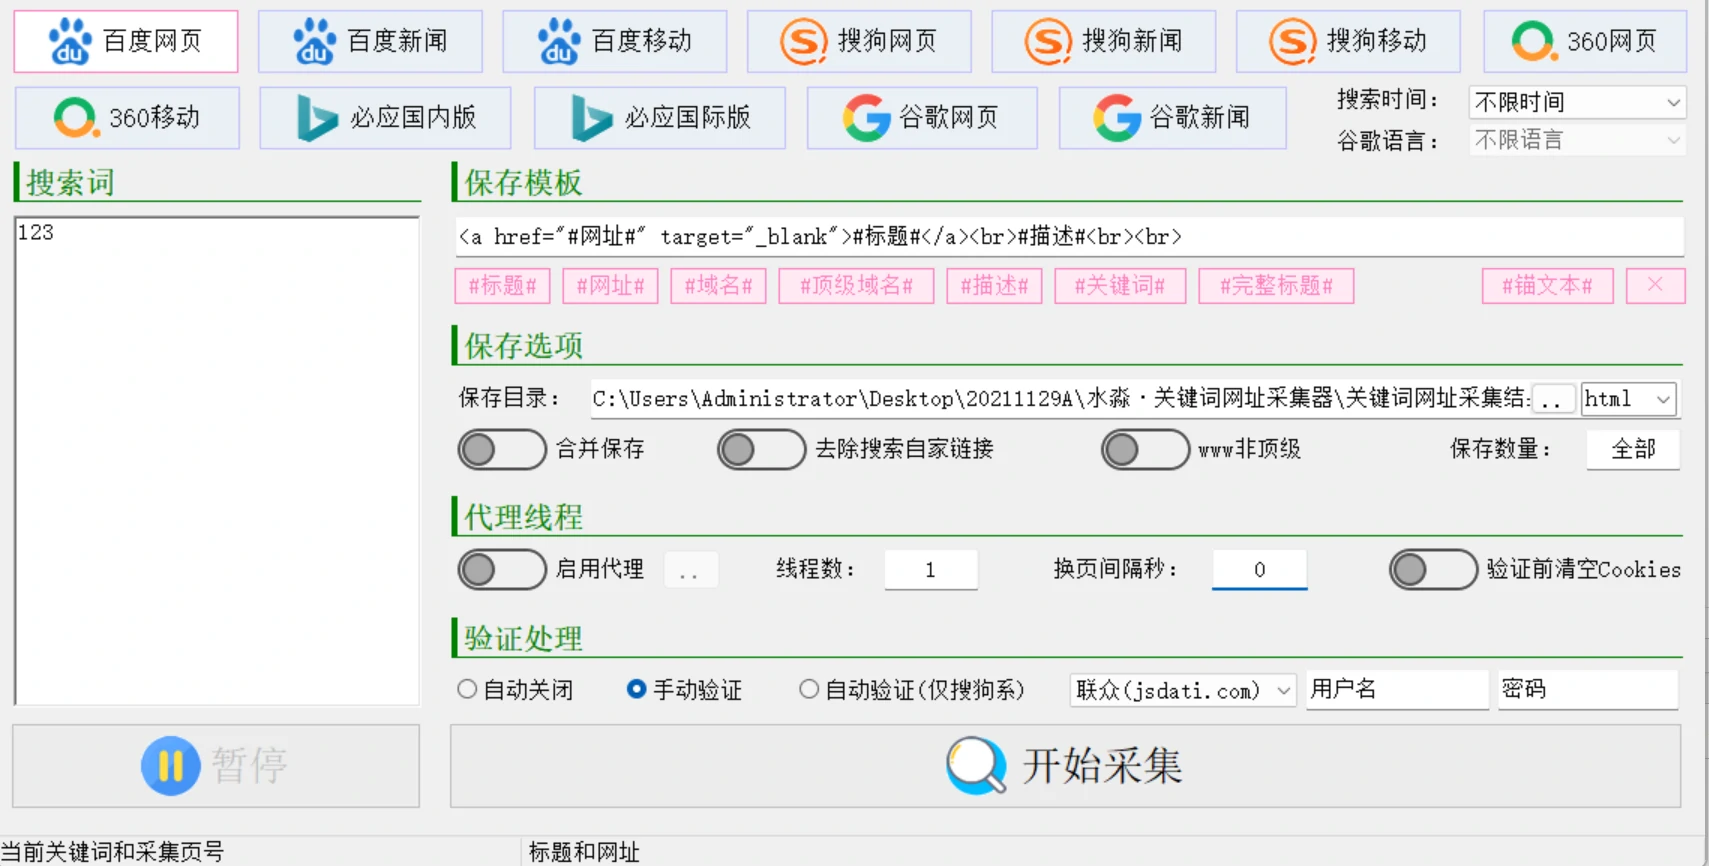
水淼关键词网址采集器3.5主界面
手动一个个搜索引擎翻页复制,一天采集不了几百条。想批量采集,又怕采集频率太高被搜索引擎封IP。文章源自指令流-https://zhilingliu.cloud/475.html
这篇从技术角度聊聊这款水淼关键词网址采集器3.5的实现逻辑,以及实际使用时需要注意的几个点。文章源自指令流-https://zhilingliu.cloud/475.html
核心逻辑:多引擎切换与模板保存
这类工具的基本思路是:输入搜索词 → 选择搜索引擎 → 配置模板 → 批量采集 → 保存结果。文章源自指令流-https://zhilingliu.cloud/475.html
界面分两块:上方是搜索引擎选择区,包含百度网页、百度新闻、百度移动、搜狗网页、搜狗新闻、搜狗移动、360网页、360移动、必应国内版、必应国际版、谷歌网页、谷歌新闻等13个引擎;下方是采集配置区,包含搜索词、保存模板、保存选项、代理线程、验证处理五个模块。文章源自指令流-https://zhilingliu.cloud/475.html
多引擎切换是这款工具比较实用的设计。不同搜索引擎的结果质量和收录机制不同,可以针对不同平台配置不同的采集策略。搜索时间支持“不限时间”和指定时间段,谷歌语言支持“不限语言”和指定语言。文章源自指令流-https://zhilingliu.cloud/475.html
从采集逻辑上看,这套流程是输入关键词 → 选择引擎 → 配置模板 → 批量采集 → 保存结果。文章源自指令流-https://zhilingliu.cloud/475.html
技术实现:模板保存与代理线程
批量采集能不能跑稳,关键看两个机制的配合。文章源自指令流-https://zhilingliu.cloud/475.html
| 机制 | 作用 |
|---|---|
| 模板保存 | 自定义输出格式,支持多种变量标签 |
| 代理线程 | 分散请求来源,规避搜索引擎风控 |
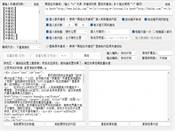
模板保存: 这是这款工具的核心设计之一。模板输入框默认是一个HTML链接格式:`#标题#
#描述#
`。下方有多个变量标签:#标题#、#网址#、#域名#、#顶级域名#、#描述#、#关键词#、#完整标题#、#锚文本#。
这些标签在采集时会被自动替换成实际内容。比如 #标题# 替换成网页标题,#网址# 替换成网页URL,#域名# 替换成网站域名。这种模板机制比单纯保存纯文本灵活得多——可以输出HTML、可以带链接、可以自定义格式。这一点和电商数据采集里讲的一样——灵活的输出格式是批量操作的基础设施。
代理线程: 代理线程区有“启用代理”、“线程数”(默认1)、“换页间隔秒”(默认0)、“验证前清空Cookies”四个配置项。批量采集最怕的就是单IP高频请求被限,代理是规避搜索引擎风控的核心。
保存选项:目录、合并与过滤
保存选项区有几个关键参数:
| 参数 | 作用 |
|---|---|
| 保存目录 | 指定结果保存位置,支持html格式 |
| 合并保存 | 所有结果合并到一个文件 |
| 去除搜索自家链接 | 过滤掉搜索引擎自己的链接 |
| www非顶级 | 把www域名视为非顶级域名处理 |
| 保存数量 | 全部或指定数量 |
“去除搜索自家链接”这个选项很实用——采集百度结果时,百度自己的产品链接(如百度知道、百度百科)会混在结果里,勾选后可以自动过滤掉。“合并保存”适合需要把多页结果汇总在一起的场景。
验证处理:三种验证模式
验证处理区提供三种验证模式:
| 模式 | 作用 |
|---|---|
| 自动关闭 | 遇到验证码自动关闭任务 |
| 手动验证 | 手动输入验证码 |
| 自动验证(仅搜狗系) | 对接搜狗系验证码平台自动处理 |
“自动验证”对接的是联众打码平台(jsdati.com),需要填写用户名和密码。批量采集时验证码是最大的卡点,自动验证可以大幅提升采集效率。
运行控制:暂停与开始采集
底部有“暂停”和“开始采集”两个控制按钮。最下方状态栏显示“当前关键词和采集页号”和“标题和网址”,实时反馈采集进度。这和浏览器中控工具里的多账号管理思路一样——实时状态反馈是批量操作的基础设施。
实际使用时的几个注意点
- 代理建议启用:不启用代理,批量采集同一IP容易被搜索引擎封
- 换页间隔不要设0:默认0秒,建议至少设1-2秒,避免请求过快被限
- 验证码自动处理:搜狗系支持自动验证,其他引擎建议手动验证或自动关闭
- 模板标签要会用:#标题#、#网址#、#域名#等标签替换后输出,灵活度很高
- 去除自家链接建议勾选:避免搜索引擎产品链接混入结果
- 采集数量按需设置:默认“全部”,根据实际需求调整避免采集过多
FAQ(常见问题)
支持哪些搜索引擎?
13个引擎:百度网页、百度新闻、百度移动、搜狗网页、搜狗新闻、搜狗移动、360网页、360移动、必应国内版、必应国际版、谷歌网页、谷歌新闻。
支持自动验证码吗?
搜狗系支持自动验证,对接联众打码平台。其他引擎建议手动验证或自动关闭。
模板标签怎么用?
模板里写 #标题#、#网址# 等标签,采集时自动替换成实际内容。支持HTML格式。
代理必须配置吗?
建议配置。不配置代理,批量采集同一IP容易被搜索引擎封。
采集结果可以导出吗?
支持。保存目录指定位置,保存格式支持html。支持合并保存或分开保存。
这类工具的核心是多引擎切换 + 模板保存 + 代理线程 + 验证处理,把手动逐个翻页复制的流程自动化了。使用时注意配置代理、设置合理的换页间隔、用好模板标签、处理验证码,基本就能稳定运行。
结论:这款水淼关键词网址采集器3.5适合需要批量采集搜索引擎结果的场景,核心价值是多引擎切换和模板自定义输出,前提是配置好代理并处理好验证码问题。
本文仅对该工具的技术实现进行客观介绍,不涉及任何违规使用引导,请用户遵守相关法律法规及各平台服务协议。本文所有内容仅供技术科普学习,本站不提供软件、脚本成品下载,亦不承接高危工具定制开发业务。如需完整使用规范,请查阅本站《服务条款》与《免责声明》。