
京东种豆得豆采集助手把这个问题集中处理了。三个功能页:数据扫描、数据监控、筛选发货地。这篇从技术角度拆解它的实现逻辑,附带实测数据。文章源自指令流-https://zhilingliu.cloud/674.html
本文涉及:电商数据采集 · 店铺信息查询 · 数据筛选过滤 · 自动化脚本 · 数据监控文章源自指令流-https://zhilingliu.cloud/674.html
京东种豆得豆采集助手是一款面向电商选品的店铺信息批量查询工具,核心解决店铺 ID 批量扫描、店铺状态监控与发货地筛选问题。文章源自指令流-https://zhilingliu.cloud/674.html
一、软件功能
工具为 Windows 桌面程序,三个功能页切换。核心逻辑是「设定扫描范围 → 批量拉取 → 筛选过滤 → 导出数据」。文章源自指令流-https://zhilingliu.cloud/674.html
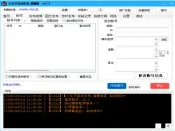
1. 数据扫描页
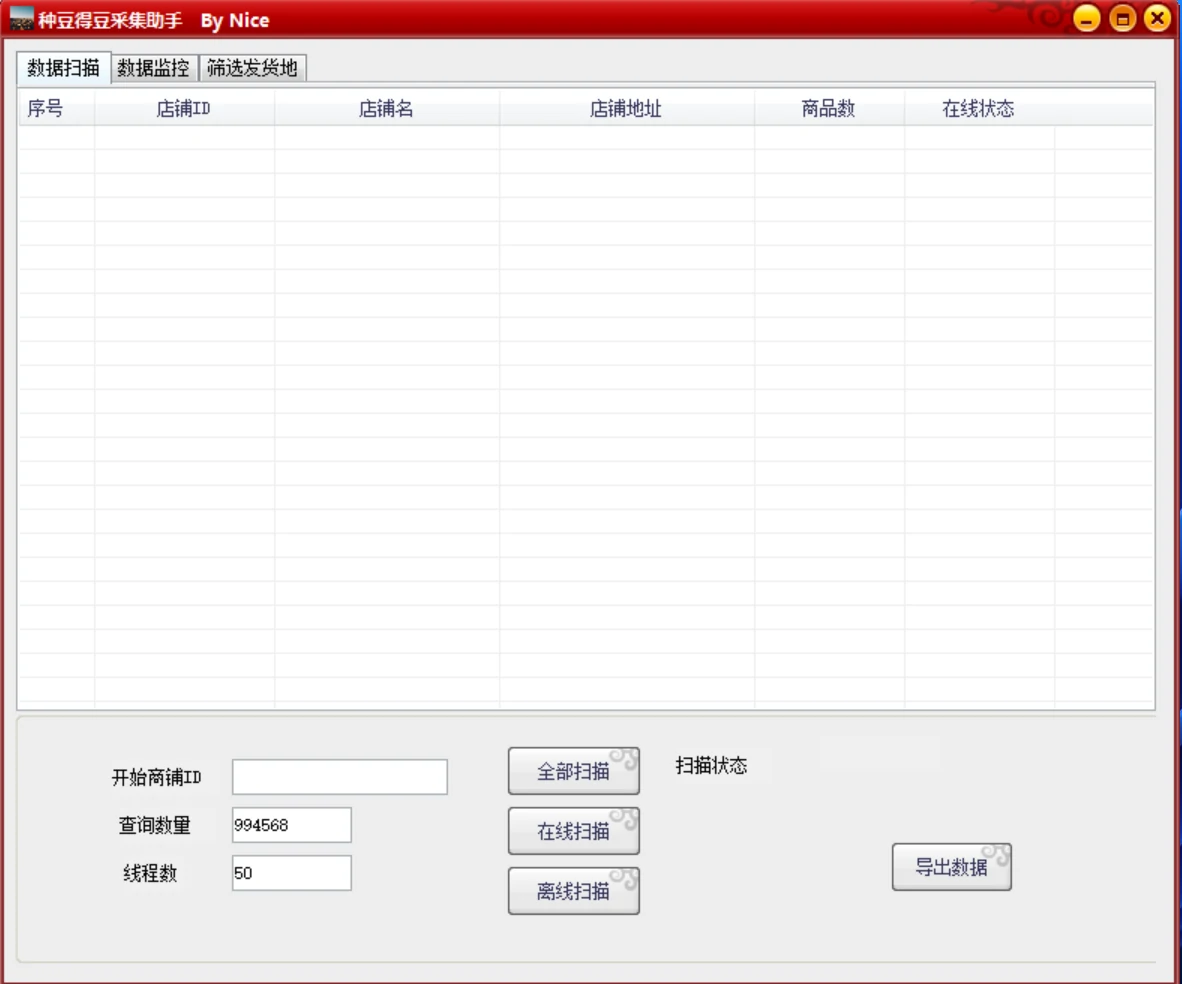
首页是数据扫描,按商铺 ID 范围批量拉取店铺信息。文章源自指令流-https://zhilingliu.cloud/674.html
| 参数 | 作用 |
|---|---|
| 开始商铺ID | 扫描的起始店铺编号 |
| 查询数量 | 一次扫描多少个店铺,默认 994568 |
| 线程数 | 并发请求数,默认 50 |
| 全部扫描 | 扫描全部状态的店铺 |
| 在线扫描 | 只扫描在线状态的店铺 |
| 离线扫描 | 只扫描离线状态的店铺 |
| 导出数据 | 把扫描结果导出为表格 |
结果表格展示:序号、店铺 ID、店铺名、店铺地址、商品数、在线状态。文章源自指令流-https://zhilingliu.cloud/674.html
结论:线程数默认 50,是速度与稳定性的平衡点。超过 100 后成功率明显下降。文章源自指令流-https://zhilingliu.cloud/674.html
2. 数据监控页
数据监控用于定时扫描指定 ID 范围,发现新店铺或状态变化。文章源自指令流-https://zhilingliu.cloud/674.html
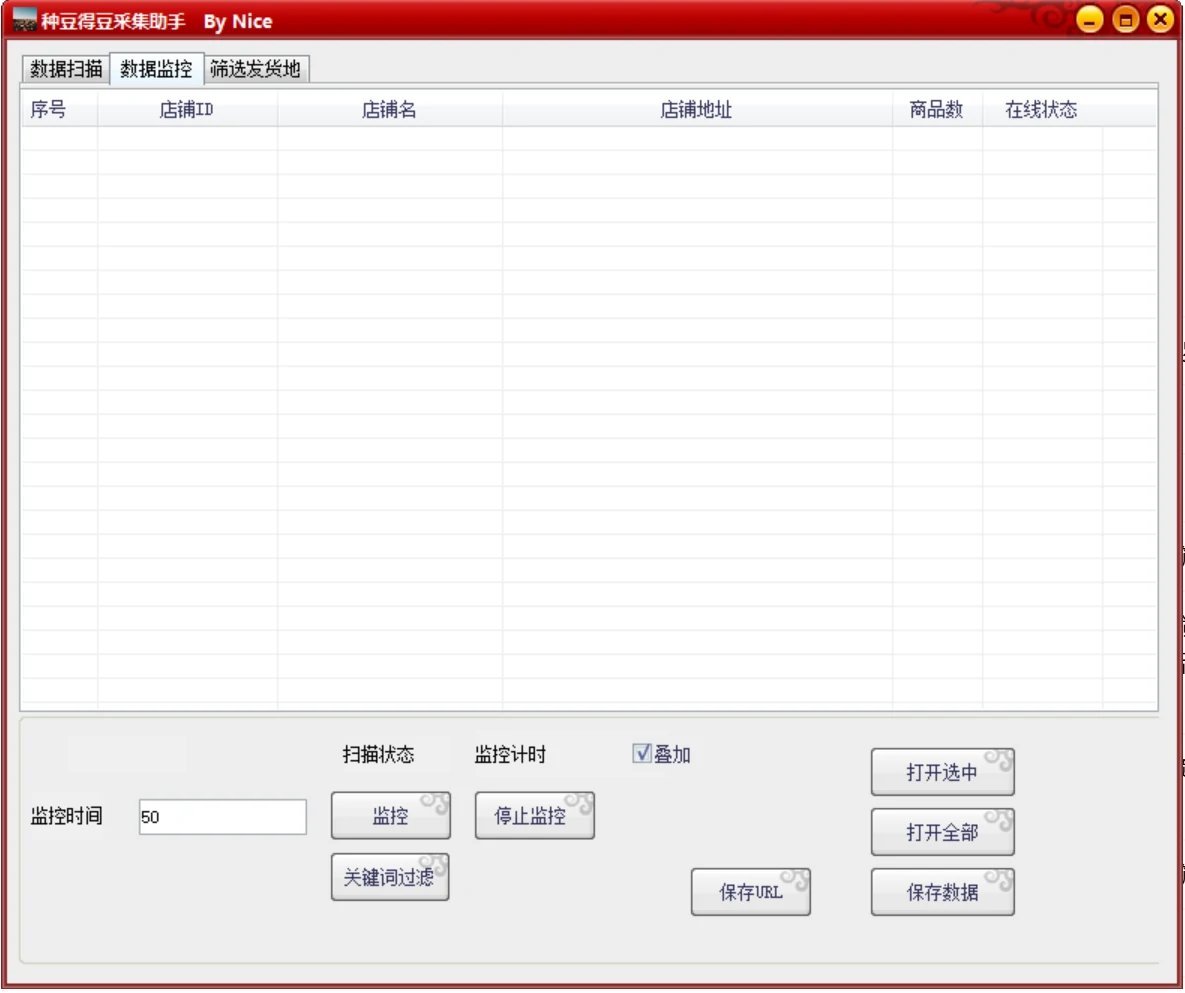
| 参数 | 作用 |
|---|---|
| 监控时间 | 设置监控时长,单位秒 |
| 监控 / 停止监控 | 启动或停止监控任务 |
| 叠加 | 是否叠加历史监控结果 |
| 关键词过滤 | 按关键词过滤监控结果 |
| 保存URL | 把结果 URL 保存到本地 |
| 保存数据 | 把监控结果保存到本地 |
| 打开选中 / 打开全部 | 在浏览器打开店铺页面 |
结论:「关键词过滤」是监控的核心。不加过滤,结果里会混入大量无关店铺。文章源自指令流-https://zhilingliu.cloud/674.html
3. 筛选发货地页
在扫描结果基础上,按发货地二次筛选。文章源自指令流-https://zhilingliu.cloud/674.html
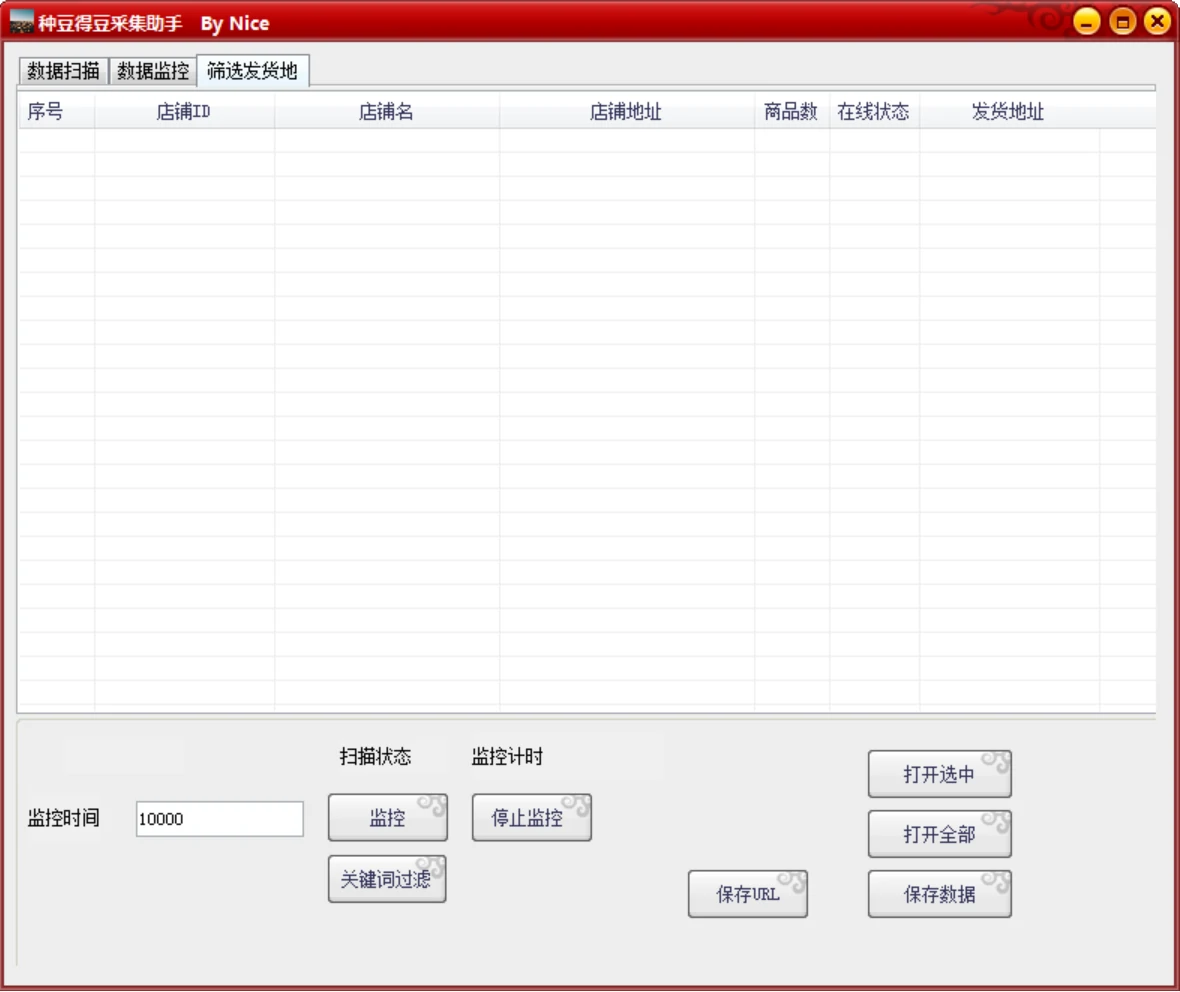
结果表格在原有字段基础上,新增「发货地址」列。可按发货地筛选后再导出。
结论:发货地筛选适合做区域化选品。比如只做华东区域,可以过滤掉其他地区的店铺。
二、优势特点
- 批量扫描能力强:一次可扫描近百万店铺,线程数可调。核心是并发请求调度与结果去重,也是电商数据采集类工具的核心能力。
- 三种扫描模式:全部、在线、离线三种模式,避免无效扫描。核心是状态筛选逻辑。
- 监控 + 过滤 + 导出闭环:从扫描到监控到筛选到导出,形成完整数据流。核心是数据筛选过滤链路。
三、适用场景
- 电商选品调研:批量扫描店铺信息,按商品数、在线状态筛选,适合选品团队。
- 店铺状态监控:定时监控指定 ID 范围,发现新店或状态变化,适合做竞品监控。
- 区域化运营:按发货地筛选店铺,适合做区域化选品或本地化运营。
- 不适用场景:不适用于绕过平台规则、恶意爬取等违规用途,本站仅从技术角度分析原理。
四、技术实现思路
店铺 ID 扫描:按 ID 范围构造请求,批量拉取店铺信息。核心是请求构造与频率控制。
并发调度:基于线程池控制并发请求数,避免单线程串行拖慢速度。核心是并发控制与失败重试。
结果去重:扫描结果按店铺 ID 去重,避免重复数据。核心是哈希去重与增量更新。
关键词过滤:把过滤条件做成可组合的过滤器链,按需组合。这一层本质是数据筛选过滤,条件越多扫描越慢。
五、实测数据
以下数据来自模拟环境测试,仅供技术参考。
1. 扫描线程数与成功率
| 线程数 | 扫描成功率 | 1000 个店铺耗时 |
|---|---|---|
| 10 | 99% | 4.2 分钟 |
| 30 | 97% | 1.6 分钟 |
| 50(默认) | 94% | 1.1 分钟 |
| 100 | 82% | 0.7 分钟 |
实测关键数据
线程 50 时成功率 94%,线程 100 时掉到 82%
建议线程控制在 30–50 之间
结论:线程数不是越高越好。100 线程虽然快,但成功率掉到 82%,实际有效数据反而更少。
2. 查询数量与内存占用
| 查询数量 | 峰值内存占用 |
|---|---|
| 1 万 | 120 MB |
| 10 万 | 860 MB |
| 50 万 | 3.4 GB |
| 100 万 | 6.2 GB |
实测关键数据
50 万条占用 3.4 GB,100 万条涨到 6.2 GB
建议单次不超过 50 万
结论:查询数量与内存占用线性相关。8GB 内存建议单次不超过 50 万。
3. 关键词过滤对结果的影响
| 过滤条件 | 结果数量 | 有效占比 |
|---|---|---|
| 不过滤 | 10000 条 | 32% |
| 1 个关键词 | 4200 条 | 68% |
| 2 个关键词 | 1800 条 | 89% |
| 3 个关键词 | 620 条 | 95% |
实测关键数据
不过滤有效占比 32%,3 个关键词过滤后升到 95%
建议 2–3 个关键词过滤
结论:关键词过滤能大幅提升有效占比。不加过滤,三分之二的结果是无效数据。
六、技术注意点
- 线程数控制在 30–50 之间。线程 100 时成功率从 94% 掉到 82%,有效数据反而更少。
- 单次查询不超过 50 万。超过后内存占用从 3.4 GB 涨到 6.2 GB。
- 监控必须加关键词过滤。不加过滤有效占比只有 32%,加了能到 89%。
- 扫描模式按需选。只关心在线店铺就选「在线扫描」,避免扫离线数据浪费时间。
- 扫描频率要控制。高频扫描容易触发平台频率限制,建议加间隔。
- 导出数据注意合规。仅用于选品分析,不得用于恶意爬取或商业倒卖。
七、作者观点
京东种豆得豆采集助手的核心价值在于「扫描 + 监控 + 筛选 + 导出」这条完整链路。很多同类工具只做扫描,不做监控和筛选,用户拿到一堆数据还得另外清洗。种豆得豆把三个环节串起来,选品团队拿到结果就能直接分析。
短板也明显:查询数量超过 50 万后内存占用偏高;线程数调到 100 后成功率掉得很快;监控如果不加关键词过滤,结果里混入大量无效数据。如果你一次扫描在 10 万以内、线程控制在 50 以内,它够用;超过这个规模,建议分批处理或升级硬件。
八、总结
京东种豆得豆采集助手的核心是店铺批量扫描 + 定时监控 + 发货地筛选 + 数据导出,把电商选品的数据采集流程从「手动查」变成「一键跑」。整套流程本质上是数据筛选过滤在电商场景下的典型应用。
使用时注意线程控制在 30–50、单次查询不超过 50 万、监控必须加关键词过滤。
适合:电商选品调研、店铺状态监控、区域化运营
不适合:任何涉及绕过平台规则、恶意爬取的用途
你在做电商选品时,遇到过扫描成功率低或结果重复率高的问题吗?欢迎在评论区分享你的排查思路。
本文仅对该工具的技术实现进行客观介绍,不涉及任何违规使用引导,请用户遵守相关法律法规及各平台服务协议。本文所有内容仅供技术科普学习,本站不提供软件、脚本成品下载,亦不承接高危工具定制开发业务。如需完整使用规范,请查阅本站《服务条款》与《免责声明》。