
做数据整理工作,经常会遇到一个场景:手里有两批数据,需要按某个字段做关联匹配——比如一批是账号列表,另一批是关联信息,怎么快速把两批数据对应起来?
我最近测了一款本地数据关联查询工具(QQ数据库v0.0.3),它支持手机反查Q和Q反查手机两个方向,核心解决的是批量数据匹配的问题。这篇文章从功能、场景、注意事项三个角度,讲清楚它能干什么、适合谁用、怎么用不出问题。文章源自指令流-https://zhilingliu.cloud/491.html
它能干什么?五个核心功能
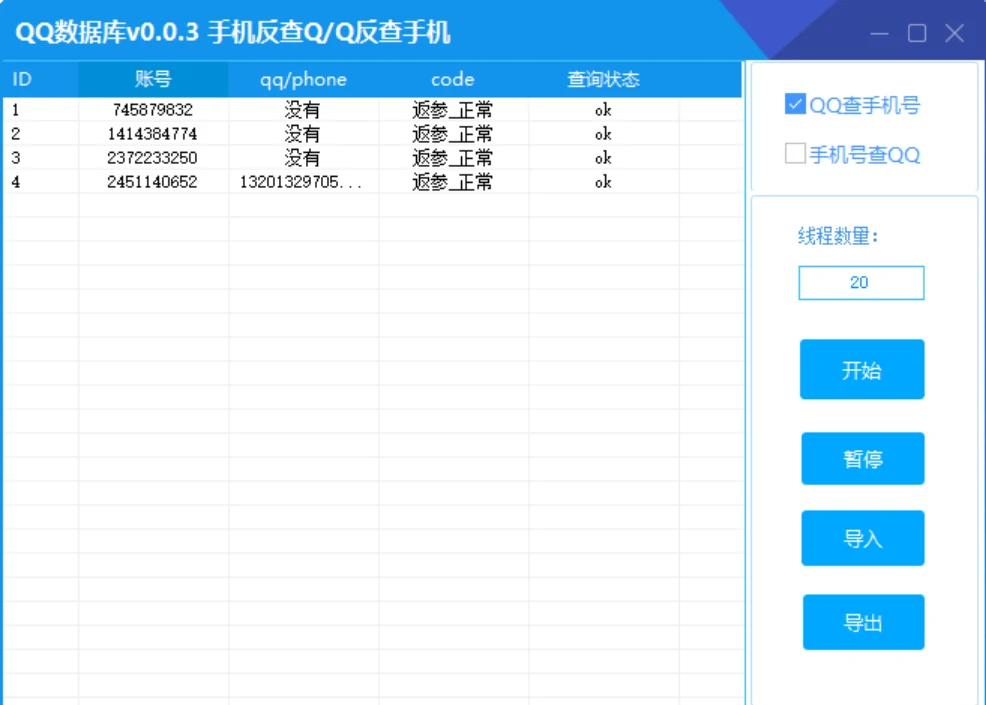
QQ数据库v0.0.3工具主界面
工具界面分两块:左侧是数据表格,右侧是查询配置和操作按钮。文章源自指令流-https://zhilingliu.cloud/491.html
1. 双向关联查询
右侧有两个查询方向选项:“QQ查手机号”和“手机号查QQ”。用户可以根据实际需求选择查询方向,两个方向是互斥的,同一时间只能选一个。文章源自指令流-https://zhilingliu.cloud/491.html
2. 多线程批量查询
线程数量默认设为20。这意味着工具可以同时发起20个查询任务,把批量匹配的效率提升到手动操作的几十倍。文章源自指令流-https://zhilingliu.cloud/491.html
3. 批量数据导入导出
右下角提供了“导入”和“导出”按钮。支持批量导入待查询的数据列表,查询完成后导出结果。这个功能和常见的社媒运营软件里的数据导入导出是同一套逻辑——批量处理、批量输出。文章源自指令流-https://zhilingliu.cloud/491.html
4. 查询状态实时回写
表格包含ID、账号、qq/phone、code、查询状态五个字段。每一行数据的查询结果会实时回写到表格里,code字段显示返回状态(截图里显示“返参_正常”),查询状态显示“ok”。文章源自指令流-https://zhilingliu.cloud/491.html
5. 暂停与恢复
提供了“开始”和“暂停”按钮,支持任务中途暂停与恢复。这在批量查询中很实用——中途需要调整参数或检查数据时,可以先暂停,不用重新开始。文章源自指令流-https://zhilingliu.cloud/491.html
它适合谁用?三类典型场景
以下场景仅供数据处理用途参考。文章源自指令流-https://zhilingliu.cloud/491.html
场景一:数据清洗与整理
手里有两批数据需要按某个字段做关联匹配。手动用Excel的VLOOKUP也能做,但数据量大了会很慢。用多线程工具批量处理,效率高得多。文章源自指令流-https://zhilingliu.cloud/491.html
场景二:数据库测试与验证
开发或测试过程中,需要批量验证数据关联关系。工具支持多线程并行查询,比手动逐个核对快几十倍。文章源自指令流-https://zhilingliu.cloud/491.html
场景三:批量数据核对
需要核对大量数据的一致性。工具支持导入导出,方便和其他系统对接。
如果你只是偶尔查几条数据,手动就够了。但如果数据量超过几百条,这类工具的效率优势就非常明显了。
它的优点:我实际用下来感受最深的3点
优点一:双向查询灵活
“QQ查手机号”和“手机号查QQ”两个方向可选,覆盖了两种常见的查询需求。比那些只能单向查询的工具更灵活。
优点二:多线程效率高
默认线程数是20。我在测试时导入了几十条数据,几十秒就跑完了。如果换成手动逐个查询,至少要十几分钟。这种自动化脚本的并发模型,和之前讲过的群控工具思路一致——都是靠多线程并行提升吞吐量。
优点三:导入导出方便
支持批量导入和导出,方便和Excel、数据库等工具对接。查询结果直接导出成表格,后续处理很方便。
和其他方案比,它强在哪?
| 方案 | 优势 | 劣势 |
|---|---|---|
| Excel手动匹配 | 零成本 | 数据量大时极慢,无法做关联查询 |
| 在线查询工具 | 无需安装 | 通常有频率限制,不适合批量 |
| 这款本地工具 | 多线程批量+导入导出 | 需要本地运行环境 |
它的核心优势是“批量+本地”。数据不需要上传到第三方平台,在本地完成处理,适合对数据隐私有要求的场景。
它的注意事项:用之前必须知道这4点
1. 严格遵守法律法规
这类数据关联查询工具,最容易触碰法律红线。使用前务必确认:查询的数据是否有合法授权?用途是否合规?《个人信息保护法》对个人信息的收集、使用有严格规定,切勿越界。
2. 只查询自有授权数据
工具本身只是技术手段。查什么、为什么查,取决于使用者。建议只用于自有数据的整理和测试,不要查询非授权数据。这和账号检测算法里强调的边界一样——工具是中性的,用途决定性质。
3. 查询频率要控制
虽然工具默认20线程,但线程数不是越高越好。查询频率太高,容易被目标系统识别为异常请求。建议从低线程数开始测试。
4. 数据不要外泄
查询结果导出后,建议妥善保管。如果涉及敏感信息,用完及时删除,避免外泄风险。
使用建议:从新手到稳定运行的路径
| 阶段 | 操作 | 目标 |
|---|---|---|
| 第一步 | 小批量测试(导入3-5条数据) | 验证查询方向、状态回写是否正常 |
| 第二步 | 确认查询数据的合法来源 | 避免法律风险 |
| 第三步 | 逐步加大批量 | 稳定后扩大到几百条 |
| 第四步 | 查询完成后立即导出 | 方便后续处理 |
不要一上来就导入几千条数据。先小批量跑通完整流程,稳定后再批量扩量,这是所有批量查询工具的正确用法。
常见问题(FAQ)
Q:两个查询方向可以同时用吗?
A:界面是两个互斥的选项,同一时间只能选一个。
Q:线程数设多少合适?
A:默认是20。建议从低开始测,稳定后再逐步加。
Q:查询结果怎么导出?
A:点右下角的“导出”按钮,结果会保存成表格文件。
Q:工具需要联网吗?
A:从功能设计看,查询需要连接数据库。具体的网络依赖情况以工具实际使用为准。
总结
这款QQ数据库v0.0.3的核心价值是“批量匹配+本地处理”。它通过双向查询、多线程并行、导入导出等功能,把批量数据匹配的效率提升到手动操作的几十倍。
适合:数据清洗与整理、数据库测试与验证、批量数据核对(自有授权数据)。
不适合:任何涉及非授权个人信息的查询用途。
结论:这款工具适合数据量超过几百条、需要批量关联匹配的场景,核心价值是通过多线程并行和导入导出实现批量数据关联查询,前提是确保所有查询数据都是自有授权数据。
使用时务必遵守法律法规,只查询自有授权数据,控制查询频率,避免触碰法律红线。
本文仅对该工具的技术实现进行客观介绍,不涉及任何违规使用引导,请用户遵守相关法律法规及各平台服务协议。本文所有内容仅供技术科普学习,本站不提供软件、脚本成品下载,亦不承接高危工具定制开发业务。如需完整使用规范,请查阅本站《服务条款》与《免责声明》。